← 전체 프로젝트

01. 한 줄로 보는 RedOceanMap

RedOceanMap

서울 상권 공공데이터와 주식 시세를 대화로 분석하는 서비스 — 소형 로컬 LLM의 한계를 아키텍처로 보완했습니다

기간
2026-05-22 ~ 진행 중
팀 · 역할
1명 · 1인 개발 (백엔드·프론트·인프라·평가)
  • Python 3.13
  • FastAPI
  • SQLAlchemy 2
  • PostgreSQL · pgvector
  • Redis
  • Ollama Gemma 4
  • Gemini
  • Next.js 16
  • k3s
  • Cloudflare Tunnel
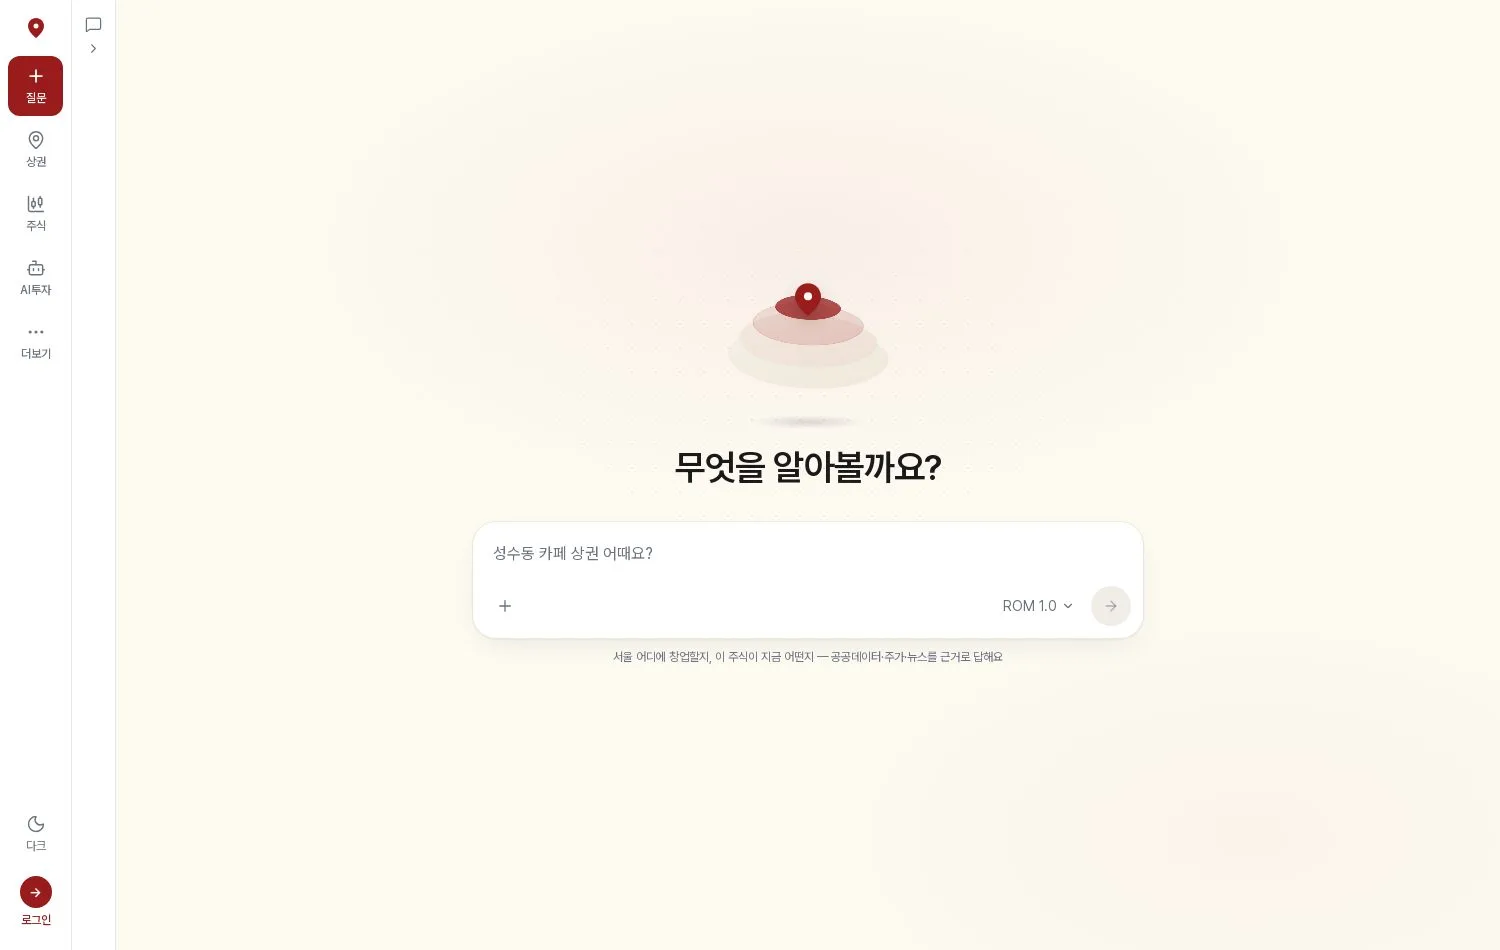
RedOceanMap 대표 화면

↓ 스크롤 또는 ← → 키로 넘기기

02. 설계 원칙 - 기계가 검사하는 아키텍처

혼자 만드는 모놀리식에서 앱 8개가 엉키지 않도록, 구조 규칙을 문서가 아니라 자동 검사 계약으로 만들었습니다.
문제
1인 모놀리식에서 앱 8개가 서로를 직접 참조하며 엉킬 위험. CI도 두지 않기로 해 사람의 리뷰에 기댈 수 없었다
선택
앱 내부는 헥사고날(adapter → app → domain), 앱 사이는 허브-스포크. import-linter 계약 5종으로 강제
대가
스포크끼리 협력할 때마다 허브에 포트를 새로 만들어야 한다 (예 — StockStatusPort 신설)
효과
구조 위반이 리뷰가 아니라 검사 실패로 드러난다. 기록된 결과 "계약 5 KEPT"
허브-스포크와 헥사고날 레이어 (도식)

왜 이 선택인가 — 버린 대안

  • 마이크로서비스 분리 + 메시지 브로커
    1인 규모에서 운영 부담만 늘어나는 과설계로 판단해 로드맵의 비추천 목록에 명시

import-linter 계약이란?

건물 도면에 "이 층에서 저 층으로 배관을 바로 잇지 말 것"을 적어 두고, 공사 중 자동 검사기가 위반을 찾아 경보를 울리는 것과 같습니다. 규칙을 사람의 기억이 아니라 도구가 지킵니다.

근거: minseok/.importlinter — 계약 5종 · ROADMAP — 계약 5 KEPT · 과설계 목록

03. 결정론 가드 - 규칙은 프롬프트가 아니라 코드가 지킨다

소형 모델은 프롬프트에 적힌 규칙도 어겼습니다. 그래서 숫자와 금지 사항은 코드가 집행하고, 모델은 문장만 쓰게 했습니다.
문제
7.8B 모델이 '주의' 등급 상권을 "강력히 추천"하는 등 프롬프트에 이미 있는 규칙을 어겼다
선택
없는 데이터는 코드가 첫 문장에 "없다"고 넣고, 조건 질의의 정렬도 코드가 한다
대가
가드 코드가 늘고, 가드가 실패를 가린 사고가 있었다 — 컨텍스트 초과로 답변이 전부 죽었는데 지표는 정상으로 보여 4일간 탐지 못함
효과
조건 질의 62초 오류 → 1.5초 정답
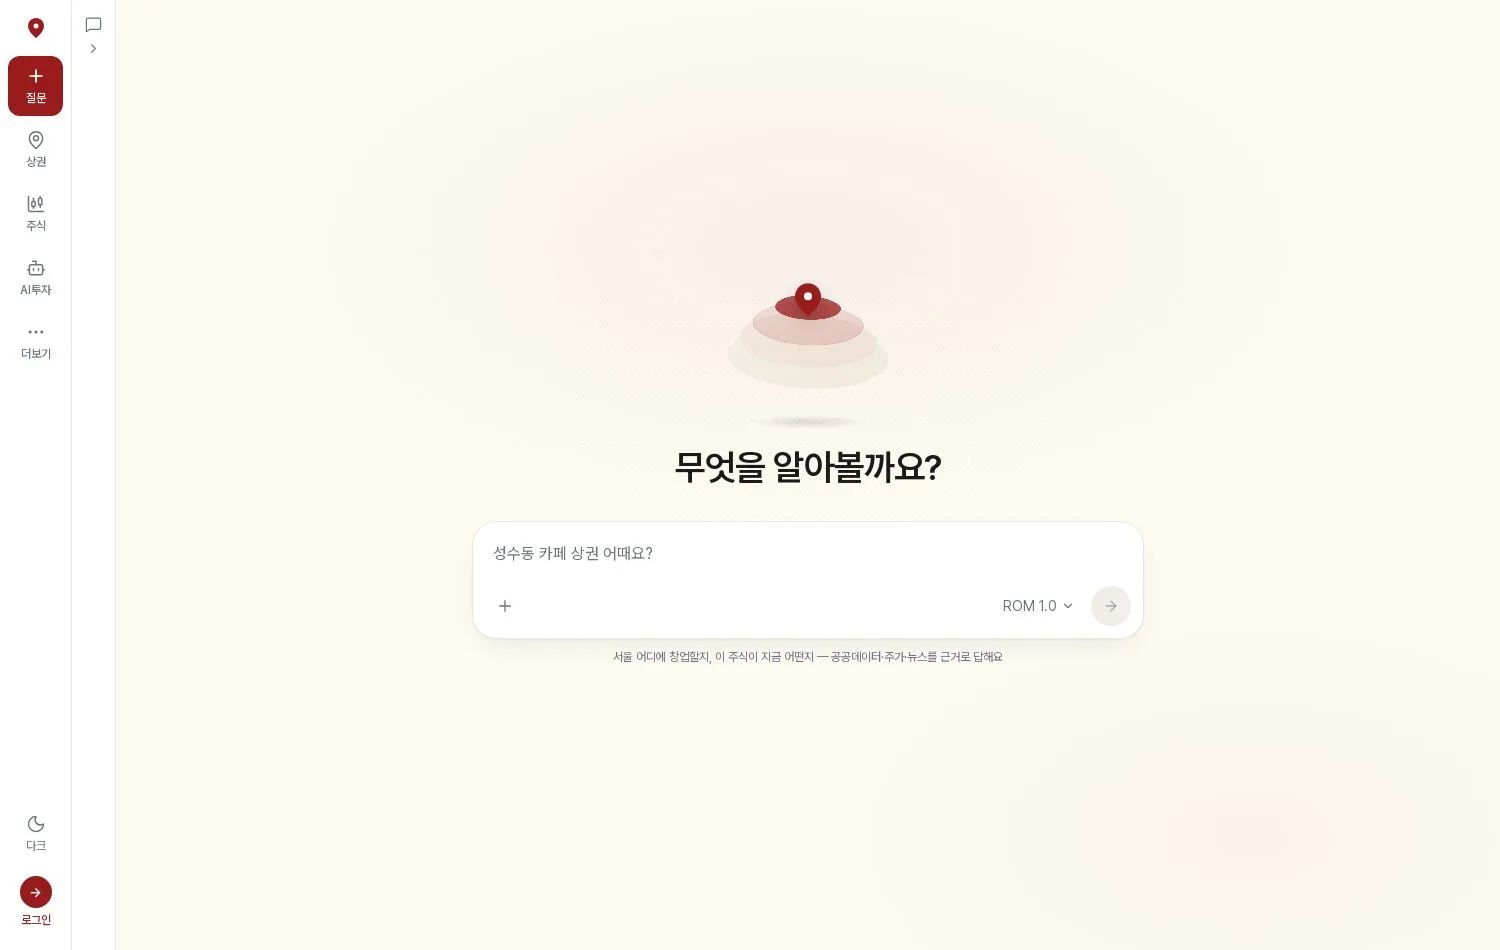
질문 홈 — 근거 데이터를 밝히는 안내
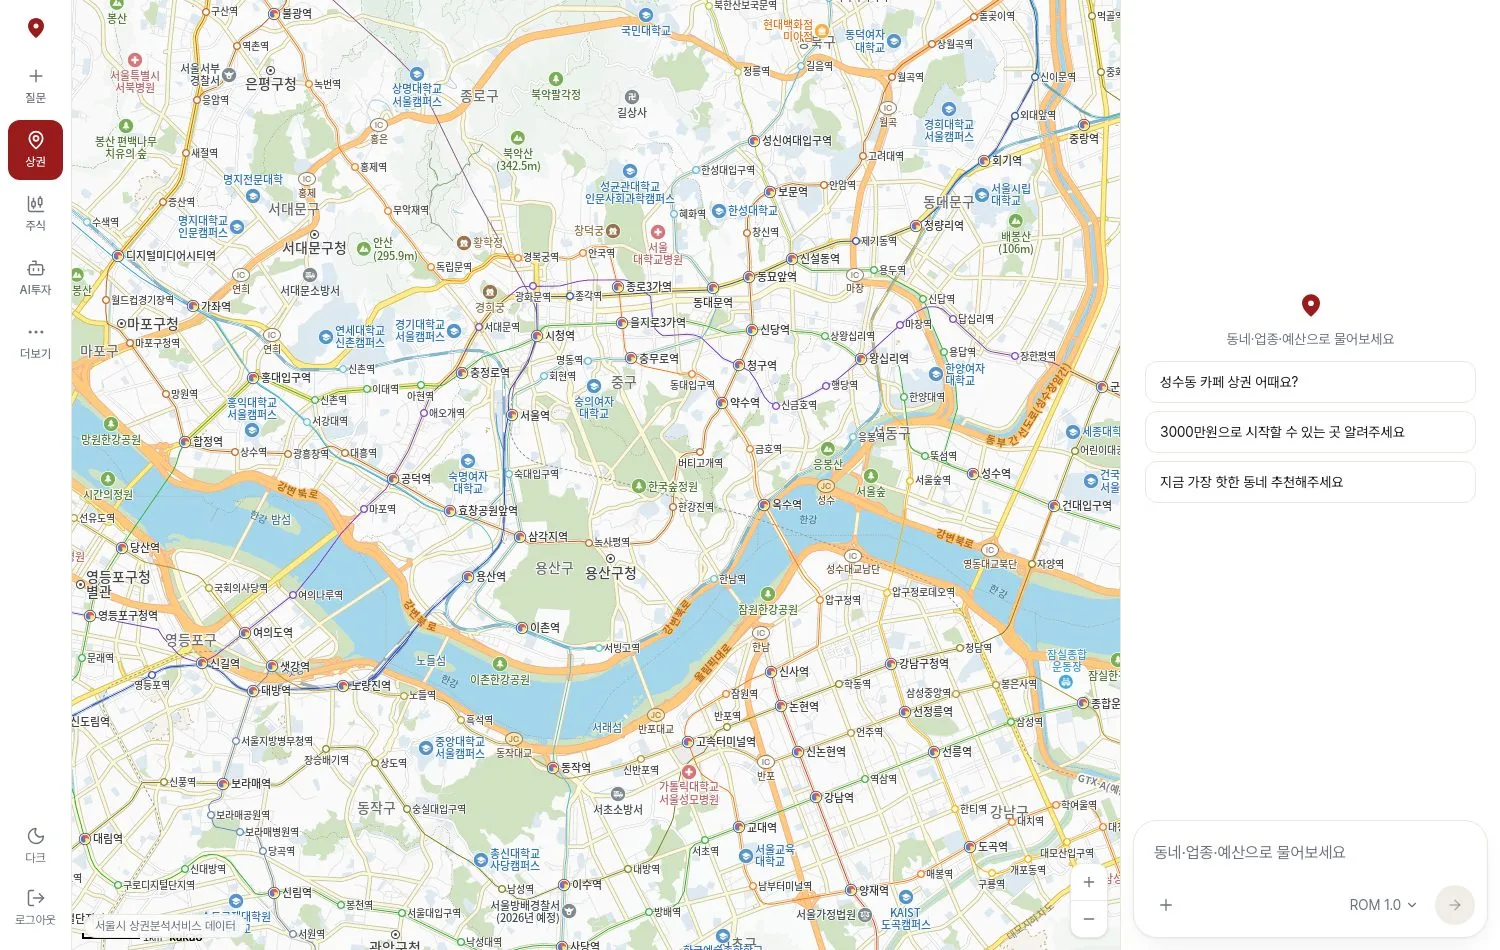
상권 지도와 대화 패널
상권 지도와 대화 패널
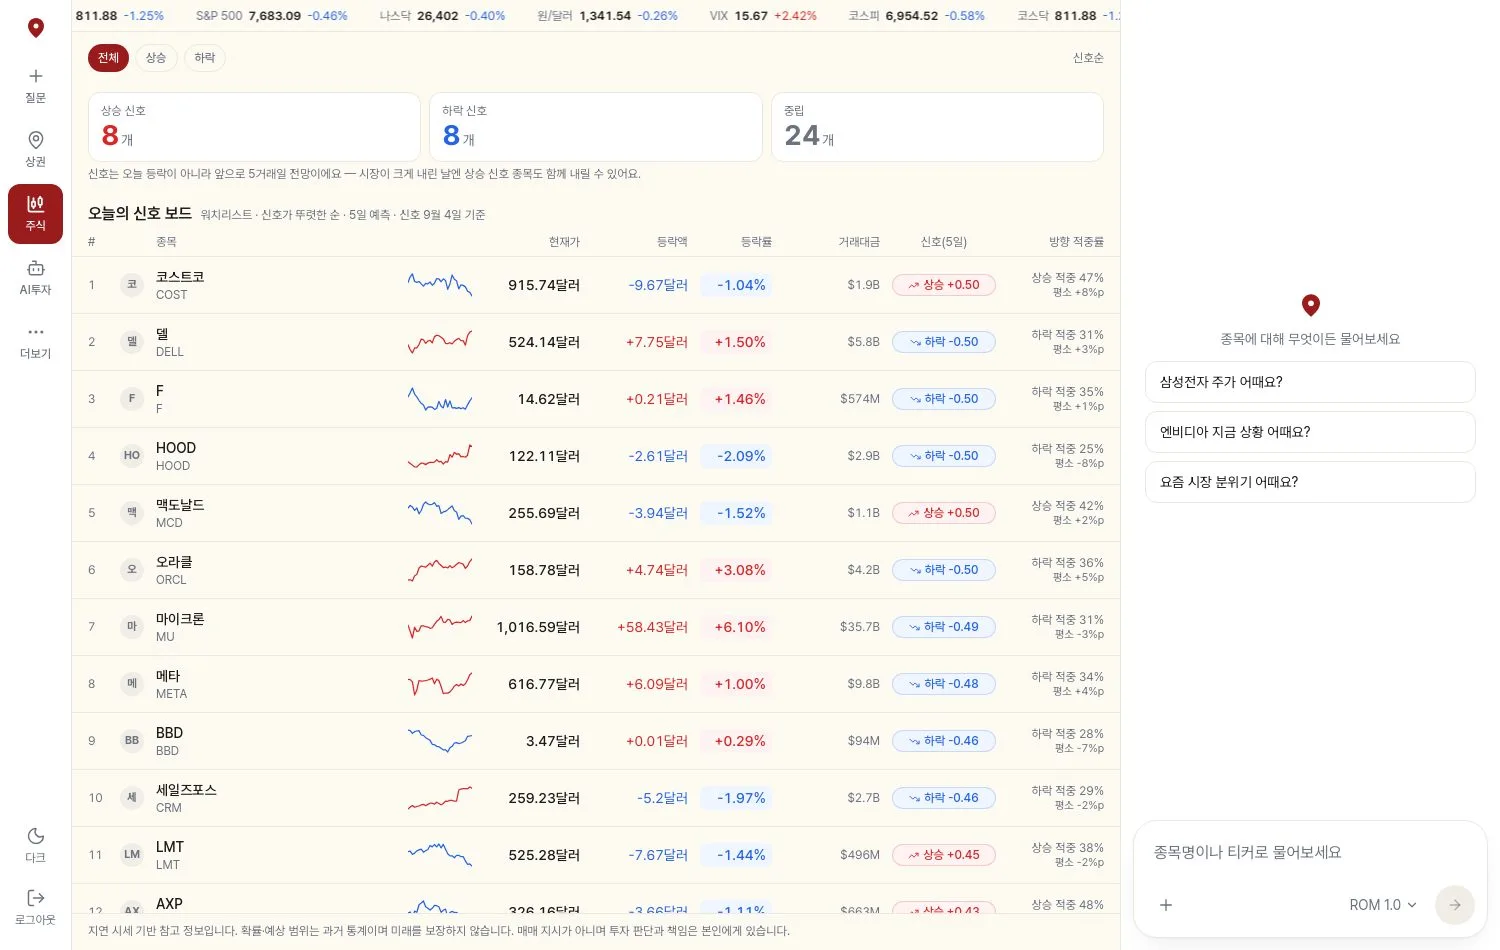
신호 보드 — 적중률과 "매매 지시 아님" 고지

왜 이 선택인가 — 버린 대안

  • 프롬프트 문구 보강
    규칙은 이미 프롬프트에 다 있었다 — 문구를 더 쓰는 것으로는 막지 못했다
  • 더 큰 모델
    8GB VRAM 제약으로 12B급은 후보에서 제외

결정론 가드란?

신입 직원에게 매번 말로 당부하는 대신, 결재 시스템에 "이 조건이면 자동 반려"를 걸어 두는 방식입니다. AI는 문장을 쓰고, 숫자와 금지 사항은 프로그램이 최종 확인합니다.

근거: 블로그 — 결정론 가드 · ROADMAP — num_ctx 사고 기록

04. 골든셋 회귀 평가 - LLM 품질을 시험으로 관리

프롬프트나 모델을 바꿀 때마다 같은 시험을 다시 치고, 규칙으로 채점합니다. 라이선스 문제로 모델을 교체할 때도 이 시험을 통과한 뒤에만 투입했습니다.
문제
프롬프트·모델을 바꿔도 품질이 떨어졌는지 알 수 없었다. 이후 생성 모델(EXAONE)이 출력물 상용 금지 라이선스로 드러나 교체가 필요했다
선택
러너(실제 LLM 실행)와 게이트(커밋된 trace를 규칙으로 채점)를 분리. baseline은 최고 기록이 아니라 바닥
대가
유용함 같은 주관적 품질은 재지 못한다. 러너 1회 15~27분
효과
모델 교체 후 골든셋 144문항 오류 0 · 인용률 0.987
러너 → trace → 게이트 (도식)

왜 이 선택인가 — 버린 대안

  • LLM-as-judge
    단일 모델 정책에서 같은 모델이 자기 답을 채점하는 순환 평가가 된다
  • Llama 3.1 8B · Kanana
    같은 골든셋에서 각각 지하철 노선을 지어내고 지시 준수가 약해 탈락

골든셋이란?

정답과 채점 기준이 정해진 시험 문제 모음입니다. AI를 고칠 때마다 같은 시험을 다시 치게 하고, 점수가 기준선 아래로 내려가면 변경을 반려합니다. 채점은 AI가 아니라 규칙이 합니다.

근거: chat/_docs/EVAL.md — 러너·게이트 분리 · LLM_SWAP_EVAL — 후보 5종 비교

05. 하이브리드 검색 - 측정하고 기각했다

벡터와 키워드를 섞으면 좋아질 것 같았지만, 재 보니 개선이 기준에 못 미쳐 도입하지 않았습니다. 측정해서 기각한 기록 자체가 결과물입니다.
문제
검색 품질 지표가 전혀 없었고, 한국어 형태소 분석 확장(pg_bigm·PGroonga)도 없었다
선택
TREC pooling 골든셋 40문항 + nDCG·MRR 채점기를 만들고, trigram+벡터 RRF를 채택 게이트(+0.03)로 판정
대가
라벨 풀링 편향 — 모델을 바꾸자 새로 뽑힌 문서를 다시 라벨링해야 했고, 라벨러가 사람이 아닌 LLM이었다
효과
nDCG@5 0.765 → 0.783 (+0.018 < 게이트) → 기각. 임베딩 교체 후 0.743 → 0.878
순수 벡터 vs 하이브리드 nDCG@5 (도식)

왜 이 선택인가 — 버린 대안

  • 벡터 DB 교체 (Qdrant 등)
    문제는 저장소가 아니라 측정 부재였다 — pgvector로 충분
  • LangChain retriever
    검색 단계를 직접 측정·교체할 수 있어야 해서 프레임워크에 숨기지 않음

하이브리드 검색과 RRF란?

뜻이 비슷한 글(벡터)과 글자가 겹치는 글(키워드)을 따로 찾은 뒤, 두 순위를 합쳐 최종 순위를 만드는 방식이 RRF(순위 융합)입니다. 새 임베딩에서는 오히려 −0.055로 떨어져 "임베딩이 약할 때만 이득"으로 결론을 정정했습니다.

근거: RETRIEVAL_EVAL — 게이트 판정 · LLM_SWAP_EVAL — 재측정

06. 온프레미스 배포 - 앱은 k3s, 상태는 compose

자주 바뀌는 앱은 k3s에, 데이터가 든 DB는 기존 docker compose에 두어 이관을 한 번만 하도록 나눴습니다. 비용은 0원입니다.
문제
프로덕션 compose 초안에서 결함 6건 발견 — 예) DB 주소가 localhost라 메인 DB로 조용히 폴백
선택
컴퓨트 먼저, 상태는 나중. 셀렉터 없는 Service + EndpointSlice로 연결, 포트는 루프백에만 바인딩, 외부 공개는 Cloudflare Tunnel
대가
런타임이 둘이라 브리지 네트워크를 양방향으로 배선해야 했고, 컷오버 때 수 분의 다운타임
효과
공개 health 200, 로그인 11연타 중 11번째부터 429 확인 · CronJob 7종 이상 운영
Cloudflare Tunnel → k3s → compose (도식)

왜 이 선택인가 — 버린 대안

  • DB까지 클러스터로 이관
    나중에 관리형 DB로 옮길 때 이관을 두 번 하게 된다
  • HA 구성 · Helm
    1인 온프레미스 규모에서 얻는 것보다 운영 비용이 크다

왜 둘로 나눴나?

자주 교체하는 프로그램(앱)은 자동 재시작과 배포가 쉬운 관리자(k3s)에게 맡기고, 데이터가 든 금고(DB)는 제자리에 둡니다. 나중에 금고를 클라우드로 옮길 때 이사를 한 번만 하려는 선택입니다.

근거: k3s 이관 기록 · ROADMAP — 공개 보안 점검

07. 결과와 회고

골든셋 (모델 교체 후)
144문항 오류 0
답변 인용률
0.987
검색 nDCG@5 (임베딩 교체)
0.743 → 0.878
조건 질의
62초 오류 → 1.5초 정답
상권 조회 인덱스
2.2ms → 0.065ms
커밋
407개 (1인)

아쉬운 점 · 다음에 할 것

  • 가드가 실패를 가린 사고 — 가드가 동작했는지를 따로 감시하는 지표가 필요했다
  • 검색 골든셋 라벨을 LLM이 달았다 — 사람 검수 표본을 두지 못했다
  • CI 없이 로컬 수동 검증에 의존 — 이 포트폴리오 저장소에서는 CI부터 붙였다
  • 문서마다 수치가 어긋난다 (골든셋 134 vs 144 문항) — 수치의 단일 출처가 필요하다